06 - 复现指南:GeoChat — 遥感视觉语言模型¶
预计阅读:12 分钟 | 前置知识:Hugging Face Transformers 使用经验、视觉语言模型基本概念、LoRA/PEFT 微调基础
GeoChat 是由 MBZUAI Oryx Lab 提出的遥感领域视觉语言模型(VLM),支持多轮对话、区域级理解和图像级描述等任务。
目录¶
1. 项目概述¶
- 论文标题: GeoChat: Grounded Large Vision-Language Model for Remote Sensing(CVPR 2024,arXiv:2311.15826)
- GitHub: mbzuai-oryx/GeoChat(2026-10 查:759 stars)
- Hugging Face 数据集: MBZUAI/GeoChat_Instruct(
GeoChat_Instruct.json,263 MB,图像分成多个压缩分卷) - Hugging Face 模型: MBZUAI/geochat-7B(LoRA 合并后的权重)
- 核心能力:
- 图像级描述: 对遥感图像进行全局描述
- 区域级理解: 对图像中指定区域进行细粒度分析
- 多轮对话: 支持上下文关联的多轮问答
- 视觉定位: 结合空间位置信息回答问题
模型架构概览¶
遥感图像 (RS Image, 504 x 504)
      ↓
视觉编码器 CLIP ViT-L/14(原生 336,位置编码插值到 504)
      ↓
视觉投影层 MLP(mlp2x_gelu,取 LLaVA-1.5 projector 初始化,两阶段都冻结)
      ↓
  + 文本输入 (Question/Instruction)
      ↓
语言模型 Vicuna-v1.5 (7B)   ← 由 LLaVA-1.5-7B 权重出发,只对 LLM 挂 LoRA
      ↓
文本输出 (Answer/Description)
论文原文的说法是:视觉塔为 “CLIP-ViT(L-14)”,原生 “input resolution of 336×336 … effectively 576 patches per image”,为适配遥感小目标把位置编码插值整到 “504×504 … 1296 per image”;语言塔为 “The open source Vicuna-v1.5(7B)”。
2. 仓库结构¶
以下目录树照 mbzuai-oryx/GeoChat 的 main 分支实际列出(省略 __pycache__、images/、demo_images/ 等素材目录):
GeoChat/
├── README.md
├── docs/
│   ├── MODEL_ZOO.md              # 基座、视觉塔、projector 初始化、下载链接
│   ├── Data.md                   # 指令数据与预训练数据的下载说明
│   ├── LoRA.md                   # demo、训练、合并 LoRA 权重的操作步骤
│   ├── Evaluation.md
│   └── Customize_Component.md
├── geochat/
│   ├── constants.py
│   ├── conversation.py
│   ├── mm_utils.py
│   ├── model/
│   │   ├── geochat_arch.py        # 模型架构定义
│   │   ├── builder.py             # 从 HF checkpoint 装配模型
│   │   ├── apply_delta.py         # 应用 LLaVA 增量权重
│   │   ├── consolidate.py
│   │   ├── multimodal_encoder/
│   │   │   ├── clip_encoder.py    # CLIP ViT-L/14 视觉塔
│   │   │   └── builder.py
│   │   ├── multimodal_projector/  # 视觉-语言投影层(mlp2x_gelu)
│   │   │   └── builder.py
│   │   └── language_model/
│   │       ├── geochat_llama.py   # LlamaForCausalLM + GeoChat 前向
│   │       ├── geochat_mpt.py     # MPT 版本(未在本指南用到)
│   │       └── mpt/
│   ├── train/
│   │   ├── train.py               # 训练主脚本(LoRA 秩默认值就在这儿)
│   │   ├── train_mem.py           # 入口壳,强制 flash-attn 之后再调 train.py
│   │   ├── geochat_trainer.py     # 自定义 Trainer
│   │   └── llama_flash_attn_monkey_patch.py
│   ├── eval/
│   │   ├── batch_geochat_vqa.py         # VQA(Presence / Comparison / Rural-Urban)
│   │   ├── batch_geochat_scene.py       # 场景分类(UCMerced / AID)
│   │   ├── batch_geochat_grounding.py   # 定位描述
│   │   └── batch_geochat_referring.py   # 指代表达
│   └── serve/
│       └── examples/
├── playground/
│   └── data/prompts/
│       ├── conversation/          # 000_conv.txt / 000_caps.txt / ...
│       └── system_message.txt
└── scripts/
    ├── finetune_lora.sh           # LoRA 微调(本指南第 6 节的主源)
    ├── finetune_qlora.sh
    ├── finetune_full_schedule.sh
    ├── finetune_sqa.sh
    ├── pretrain.sh                # 视觉-语言特征对齐预训练
    ├── merge_lora_weights.py
    ├── extract_mm_projector.py
    ├── zero2.json / zero3.json / zero3_offload.json
3. 环境配置¶
3.1 克隆仓库¶
3.2 创建环境¶
# 创建 conda 环境
conda create -n geochat python=3.10 -y
conda activate geochat

# 安装 PyTorch
pip install torch==2.1.2 torchvision==0.16.2 --index-url https://download.pytorch.org/whl/cu121

# 安装项目依赖
pip install -r requirements.txt

# 或通过 pyproject.toml 安装
pip install -e .
3.3 关键依赖¶
transformers>=4.36.0
tokenizers>=0.15.0
accelerate>=0.25.0
peft>=0.7.0
bitsandbytes>=0.41.0
sentencepiece
pydantic
pillow
opencv-python
datasets
wandb
einops
3.4 下载基础模型权重¶
GeoChat 的基座是 LLaVA-1.5-7B(语言塔为 Vicuna-v1.5-7B),不是原始 LLaMA-2 或 Mistral。scripts/finetune_lora.sh 里两项都写明了:
# 基座:LLaVA-1.5-7B(Vicuna-v1.5-7B 语言塔 + CLIP-L/14-336 视觉塔)
huggingface-cli download liuhaotian/llava-v1.5-7b --local-dir ./models/llava-v1.5-7b

# 视觉-语言投影层的初始化权重(LLaVA-1.5 在 558K 子集上预训练好的 projector)
# script 里的 --pretrain_mm_mlp_adapter 指向该文件
huggingface-cli download liuhaotian/llava-v1.5-mlp2x-336px-pretrain-vicuna-7b-v1.5 \
    --local-dir ./models/llava-v1.5-projector
视觉塔不单独下载——--vision_tower openai/clip-vit-large-patch14-336 会在运行时从 HF 拉取。
4. 数据集准备¶
4.1 下载 GeoChat 指令数据集¶
数据集的标注是单个 263 MB 的 JSON,图像分成多个压缩分卷。仓库 docs/Data.md 给的合并方式是先把分卷拼成一个 zip:
# 标注(单文件)
huggingface-cli download --repo-type dataset MBZUAI/GeoChat_Instruct \
    GeoChat_Instruct.json --local-dir ./data/geochat_instruct

# 图像:把 images_parta* 各分卷下到同一个目录,再拼起来解压
cd ./data/geochat_instruct && cat images_parta* > images.zip && unzip images.zip -d images
4.2 数据格式¶
它是 LLaVA 式的多轮对话格式:一条记录三个字段 id / image / conversations,conversations 里按 human 与 gpt 交替。下面这条是 GeoChat_Instruct.json 的第一条记录原文:
{
    "id": "church/church_144.jpg",
    "image": "NWPU-RESISC45/church/church_144.jpg",
    "conversations": [
        {
            "from": "human",
            "value": "<image>\nClassify the given image in one of the following classes. Classes: railway station, harbor, desert, palace, mobile home park, cloud, storage tank, medium residential, ship, tennis court, golf course, baseball diamond, snowberg, river, mountain, church, terrace, bridge, forest, parking lot, airport, roundabout, dense residential, airplane, railway, runway, sea ice, lake, rectangular farmland, thermal power station, commercial area, stadium, circular farmland, wetland, industrial area, chaparral, overpass, sparse residential, intersection, freeway, ground track field, basketball court. \nAnswer in one word or a short phrase."
        },
        {
            "from": "gpt",
            "value": "church"
        }
    ]
}
三点细节:<image> 占位符放在第一轮 human 文本的最前面;图像路径是带数据集前缀的相对路径(NWPU-RESISC45/church/church_144.jpg),不是扁平的 images/xxx.png;一次问答就能是一条记录,不必凑成多轮。
论文 §4 给出的九类指令数据与规模(Table 1):
| 数据 | 规模 | 提示形式 |
|---|---|---|
| Detailed Description | 30k | Describe the image in detail. |
| Multi-Round Conversation | 65k | — |
| Complex Questions | 10k | — |
| RSVQA-LRBEN | 56k | Answer the question using a single word or phrase. |
| NWPU-RESISC-45(场景分类) | 31.5k | — |
| Floodnet | 4k | — |
| Grounding Description | 45k | [grounding],指示要框的区域 |
| Region Captioning | 40k | [identify],带 bbox 坐标 |
| Referring Expression | 25k | [refer] 包住指代目标 |
合计约 306k,论文口径写作 “nearly 318k instructions”。
5. 模型推理¶
5.1 下载 GeoChat 微调权重¶
# 从 Hugging Face 下载已训练(LoRA 已合并)的 GeoChat-7B
huggingface-cli download MBZUAI/geochat-7B --local-dir ./models/geochat-7b
5.2 运行推理¶
仓库里没有 scripts/inference.py。可直接跑的最短入口是根目录的 geochat_demo.py(见 docs/LoRA.md):
要用命令行交互或起 Web 服务,用 geochat/serve/ 下这套 LLaVA 式三进程结构:
python -m geochat.serve.controller --host 0.0.0.0 --port 10000          # 调度
python -m geochat.serve.model_worker --host 0.0.0.0 --controller http://localhost:10000 \
    --port 40000 --worker http://localhost:40000 --model-path ./models/geochat-7b
python -m geochat.serve.gradio_web_server --controller http://localhost:10000 --model-list-mode reload
单图单问的批处理评估脚本在 geochat/eval/batch_geochat_*.py(见第 7 节)。
5.3 推理代码逻辑(示意)¶
下面是拼装输入与调用的骨架,不是仓库原文件。真实的提示词模板在 playground/data/prompts/conversation/system_message.txt 与 geochat/conversation.py 里:
from geochat.model import GeoChatForConditionalGeneration   # 与 geochat/model/builder.py 装配
from transformers import AutoTokenizer
from PIL import Image

model = GeoChatForConditionalGeneration.from_pretrained(
    "./models/geochat-7b", torch_dtype=torch.float16, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("./models/geochat-7b")

# LLaVA 式模板:system message + USER: ... ASSISTANT:
prompt = "<image>\nUSER: Describe the land use patterns in this image. ASSISTANT:"
image = Image.open("test_remote_sensing_image.png")

inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
images = process_images([image], model.config) if hasattr(model, "config") else None
out = model.generate(**inputs, images=images, max_new_tokens=512, do_sample=False)
print(tokenizer.decode(out[0], skip_special_tokens=True))
注意分辨率:送入视觉塔的图像按 504×504 处理(见 §1 架构图),不是 336×336——336 是 CLIP ViT-L/14 的原生边长。以
geochat/mm_utils.py里的process_images实际实现为准。
5.4 Gradio 演示¶
geochat_demo.py 自身会拉起 Gradio 界面(无需另写 demo.py):
6. 模型微调¶
6.1 LoRA 微调¶
仓库提供的脚本是 scripts/finetune_lora.sh(不叫 train_lora.sh)。它是 DeepSpeed 入口,实际调用的是 geochat/train/train_mem.py(先打 flash-attn 补丁再转调 train.py):
# 脚本里的关键参数原样抄自 scripts/finetune_lora.sh,路径按本地改
deepspeed --master_port=$((RANDOM + 10000)) --include localhost:0,1,2 geochat/train/train_mem.py \
    --deepspeed ./scripts/zero2.json \
    --lora_enable True \
    --model_name_or_path ./models/llava-v1.5-7b \
    --version v1 \
    --data_path ./data/geochat_instruct/GeoChat_Instruct.json \
    --image_folder ./data/geochat_instruct/images \
    --vision_tower openai/clip-vit-large-patch14-336 \
    --mm_projector_type mlp2x_gelu \
    --pretrain_mm_mlp_adapter ./models/llava-v1.5-projector/mm_projector.bin \
    --mm_vision_select_layer -2 \
    --mm_use_im_start_end False \
    --mm_use_im_patch_token False \
    --image_aspect_ratio pad \
    --bf16 True \
    --output_dir ./checkpoints/geochat-lora \
    --num_train_epochs 1 \
    --per_device_train_batch_size 32 \
    --gradient_accumulation_steps 1 \
    --learning_rate 2e-4 \
    --weight_decay 0. \
    --warmup_ratio 0.03 \
    --lr_scheduler_type "cosine" \
    --tf32 True \
    --model_max_length 2048 \
    --gradient_checkpointing True \
    --lazy_preprocess True \
    --dataloader_num_workers 16 \
    --save_strategy "epoch" --report_to wandb
脚本里没有 --lora_r / --lora_alpha,两项都走 train.py 的默认值。
6.2 训练配置详解¶
仓库里没有 configs/train_lora.yaml;全部超参写在 scripts/finetune_lora.sh 与 geochat/train/train.py 的 argparse 默认值里。逐项如下,右列注明出处:
| 参数 | 值 | 出处 |
|---|---|---|
LoRA 秩 lora_r |
64 | train.py:101 默认值;论文 §5.1 “a designated rank r set to 64”,作用在 W_q、W_v |
lora_alpha |
16 | train.py:102 默认值(注意不是 2×r,脚本也没传) |
lora_dropout |
0.05 | train.py:103 |
target_modules |
语言塔里除 lm_head 外的全部 Linear |
find_all_linear_names()(train.py:163);mm_projector、vision_tower、vision_resampler 被显式排除 |
| 视觉塔 / 投影层 | 冻结 | 论文 “keeping the MLP adaptor and the CLIP encoder frozen during training” |
learning_rate |
2e-4 | 脚本;README 超参表写 2e-5,两处不一致——LoRA 跑 2e-4 更像 LLaVA 的口径,按脚本为准 |
num_train_epochs |
1 | 脚本与 README 一致 |
per_device_train_batch_size |
32 | 脚本 |
gradient_accumulation_steps |
1 | 脚本 |
| 全局 batch | README 表写 144;脚本按 32 x 1 x GPU 数 算 |
3 卡得 96、4 卡得 128,都不是 144——两处对不上,以脚本为准 |
model_max_length |
2048 | 脚本 |
weight_decay / warmup_ratio |
0. / 0.03 | 脚本 |
| 图像边长 | 504 | 论文 “consistently at an image resolution of 504×504 throughout the whole process” |
| 优化器 / 调度 | AdamW + cosine | 论文 §5.1 |
| 两阶段 | 阶段一全量数据 1 epoch = 2400 步;阶段二只跑 grounding 再 1600 步 | 论文 §5.1,合计 4000 步 |
6.3 多 GPU 训练¶
用 DeepSpeed,不是 accelerate:
# 脚本已经是 deepspeed 入口,改 --include 后面的卡号即可
deepspeed --include localhost:0,1,2 geochat/train/train_mem.py --deepspeed ./scripts/zero2.json ...
scripts/ 下备了三份配置:zero2.json(默认被 finetune_lora.sh 引用)、zero3.json、zero3_offload.json。这里有一处仓库内部矛盾:README 写 “Training script with DeepSpeed ZeRO-3: finetune_lora.sh”,但脚本里传给 --deepspeed 的是 zero2.json。要按 README 的说明上 ZeRO-3,需手动把这一项改成 ./scripts/zero3.json;README 也给了取舍——“zero3.json is usually faster … but requires more GPU memory”,不够就退到 zero3_offload.json(参数卸载到 CPU)。
6.4 训练资源需求¶
仓库只给了一行硬数字,在 README 的 Train 一节:
| 项目 | 值 | 出处 |
|---|---|---|
| 训练硬件 | 3 x A100 (40 GB) | README:“We train GeoChat on 3 A100 GPUs with 40GB memory.” |
| 视觉指令微调耗时 | 约 25 小时 | README:“It takes around ~25 hours to finetune GeoChat-7B on 3x A100 (40G).” |
| 参考:projector 预训练耗时 | 约 3.5 小时(LLaVA-v1.5-7B,非本模型) | README |
README 同时给了一条约束:换 GPU 数时要保持全局 batch 不变,即 per_device_train_batch_size x gradient_accumulation_steps x num_gpus 固定。论文里没有 A100、也没有小时数——这类硬件细节只在 README 里。
7. 评估¶
7.1 运行评估¶
四个脚本都在 geochat/eval/ 下,各管一类任务,参数是 LLaVA 式的一套 --model-path / --image-folder / --question-file / --answers-file(默认 --conv-mode llava_v1):
# VQA(Presence / Comparison / Rural-Urban)
python geochat/eval/batch_geochat_vqa.py \
    --model-path ./models/geochat-7b \
    --image-folder ./data/images \
    --question-file ./data/vqa_questions.jsonl \
    --answers-file ./results/vqa_answers.jsonl \
    --temperature 0

# 场景分类(UCMerced / AID)
python geochat/eval/batch_geochat_scene.py  --model-path ./models/geochat-7b ...

# 定位描述 [grounding]
python geochat/eval/batch_geochat_grounding.py --model-path ./models/geochat-7b ...

# 指代表达 [refer]
python geochat/eval/batch_geochat_referring.py --model-path ./models/geochat-7b ...

# 多卡切分:同一份 question file 用 --num-chunks N --chunk-idx k 各跑一份再合并
--question-file 是 jsonl,每行一条 {question_id, image, text}。仓库里没有 scripts/eval_all.sh 这种一键全跑脚本,四类要分别起。
7.2 评估指标¶
论文实际用的指标(§5,各任务不全一样):
| 任务 | 指标 |
|---|---|
| 场景分类 | Accuracy(UCMerced、AID 两个数据集各算) |
| VQA | Accuracy,分 Presence / Comparison / Rural-Urban 三列 |
| 定位(grounding description) | acc@0.5、acc@0.25(预测框与真值框 IoU 过阈值算对),外加 METEOR |
| 区域级描述(region-level captioning) | ROUGE-1、ROUGE-L、METEOR |
| 指代表达 | Accuracy,分 Presence / Comparison 两列 |
没有 BLEU-4、没有 CIDEr、没有 GIoU、没有人工评估这一项——论文 §5 与附录里搜不到这四个词。
7.3 基线对比(论文 Table 7 / 10 原值)¶
场景分类(Accuracy,%):
| 模型 | UCMerced | AID |
|---|---|---|
| Qwen-VL | 62.90 | 52.60 |
| MiniGPT-v2 | 4.76 | 12.90 |
| LLaVA-1.5 | 68.00 | 51.00 |
| GeoChat | 84.43 | 72.03 |
VQA(Accuracy,%):对比模型里最强的 RSGPT 平均 92.29,GeoChat 平均 90.70;但 GeoChat 在 Comparison 一列(90.33)与 Rural/Urban(94.00)并不占优——RSVQA(86.32)、EasyToHard(89.94)、Bi-Modal(91.63)等专用模型在 VQA 上整体更强。GeoChat 的卖点是同一个模型同时把场景分类、VQA、定位、区域描述都做到可用。
区域级描述(Table 10):
| 模型 | ROUGE-1 | ROUGE-L | METEOR |
|---|---|---|---|
| MiniGPT-v2 | 32.1 | 31.2 | 10.0 |
| GeoChat | 87.3 | 87.2 | 83.9 |
8. 常见问题与解决方案¶
Q1: 下载的权重和脚本对不上¶
最容易踩的坑是拿错基座。scripts/finetune_lora.sh 要的是 LLaVA-1.5-7B 权重,不是裸的 Vicuna-7B;换成裸 Vicuna 会因为缺 mm_projector 而在装配阶段报错。同理,projector 初始化要用 llava-v1.5-mlp2x-336px-pretrain-vicuna-7b-v1.5,而且 docs/MODEL_ZOO.md 特意提醒:projector 必须与基座 LLM 和视觉塔是同一套,混用会让效果明显变差。
huggingface-cli download liuhaotian/llava-v1.5-7b --local-dir ./models/llava-v1.5-7b
huggingface-cli download liuhaotian/llava-v1.5-mlp2x-336px-pretrain-vicuna-7b-v1.5 \
    --local-dir ./models/llava-v1.5-projector
Q2: GPU 显存不足¶
# 方法 1: 换更大的分片配置——README 建议先试 zero3.json,不够再退 zero3_offload.json
# 方法 2: 减小 per_device_train_batch_size、同步增大 gradient_accumulation_steps
#         (README 的硬约束:三者的乘积——即全局 batch——必须保持不变)
# 方法 3: 4-bit 量化加载(推理侧重,训练要配 bitsandbytes + QLoRA 路径)
from transformers import BitsAndBytesConfig
bnb_config = BitsAndBytesConfig(load_in_4bit=True,
                               bnb_4bit_compute_dtype=torch.float16,
                               bnb_4bit_quant_type="nf4")
# 方法 4: 启用 gradient_checkpointing(脚本里已默认 True)
Q3: 图像分辨率不匹配¶
训练全程用 504×504(论文 §5.1),不是 336。336 只是 CLIP ViT-L/14 的原生边长——GeoChat 用位置编码插值把它撑到 504,patch 数从 576 涨到 1296。自己写预处理时最容易在这里弄错:
# 与训练一致:短边/整体按 504 处理(具体实现见 geochat/mm_utils.py 的 process_images)
from torchvision import transforms
transform = transforms.Compose([
    transforms.Resize((504, 504)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.48145466, 0.4578275, 0.40821073],
                         std=[0.26862954, 0.26130258, 0.27577711])
])
Q4: 多轮对话上下文丢失¶
确保在多轮推理时将完整的对话历史传入模型:
# 正确做法:累积对话历史
conversation = []
for question in multi_turn_questions:
    conversation.append({"from": "human", "value": f"<image>\n{question}"})
    # 将完整对话历史传入模型
    response = model.chat(conversation, image)
    conversation.append({"from": "gpt", "value": response})
Q5: 微调后模型性能下降¶
- 学习率:脚本用 2e-4(README 表写 2e-5,见 §6.2 的说明)——照脚本跑没问题,若自行调大要留意 LoRA 对 lr 敏感
- 训练轮数:1 epoch 是原设定的全部(论文两阶段合计 4000 步),不要按「2–3 轮」加练
- 数据侧先查图像路径与
<image>占位符是否对得上(§4.2 的NWPU-RESISC45/...前缀形式) - 分辨率是否被改成了 336(见 Q3);这项最容易悄悄拖垮效果
动手验证:3 张 A100-40G 够不够,账怎么算?¶
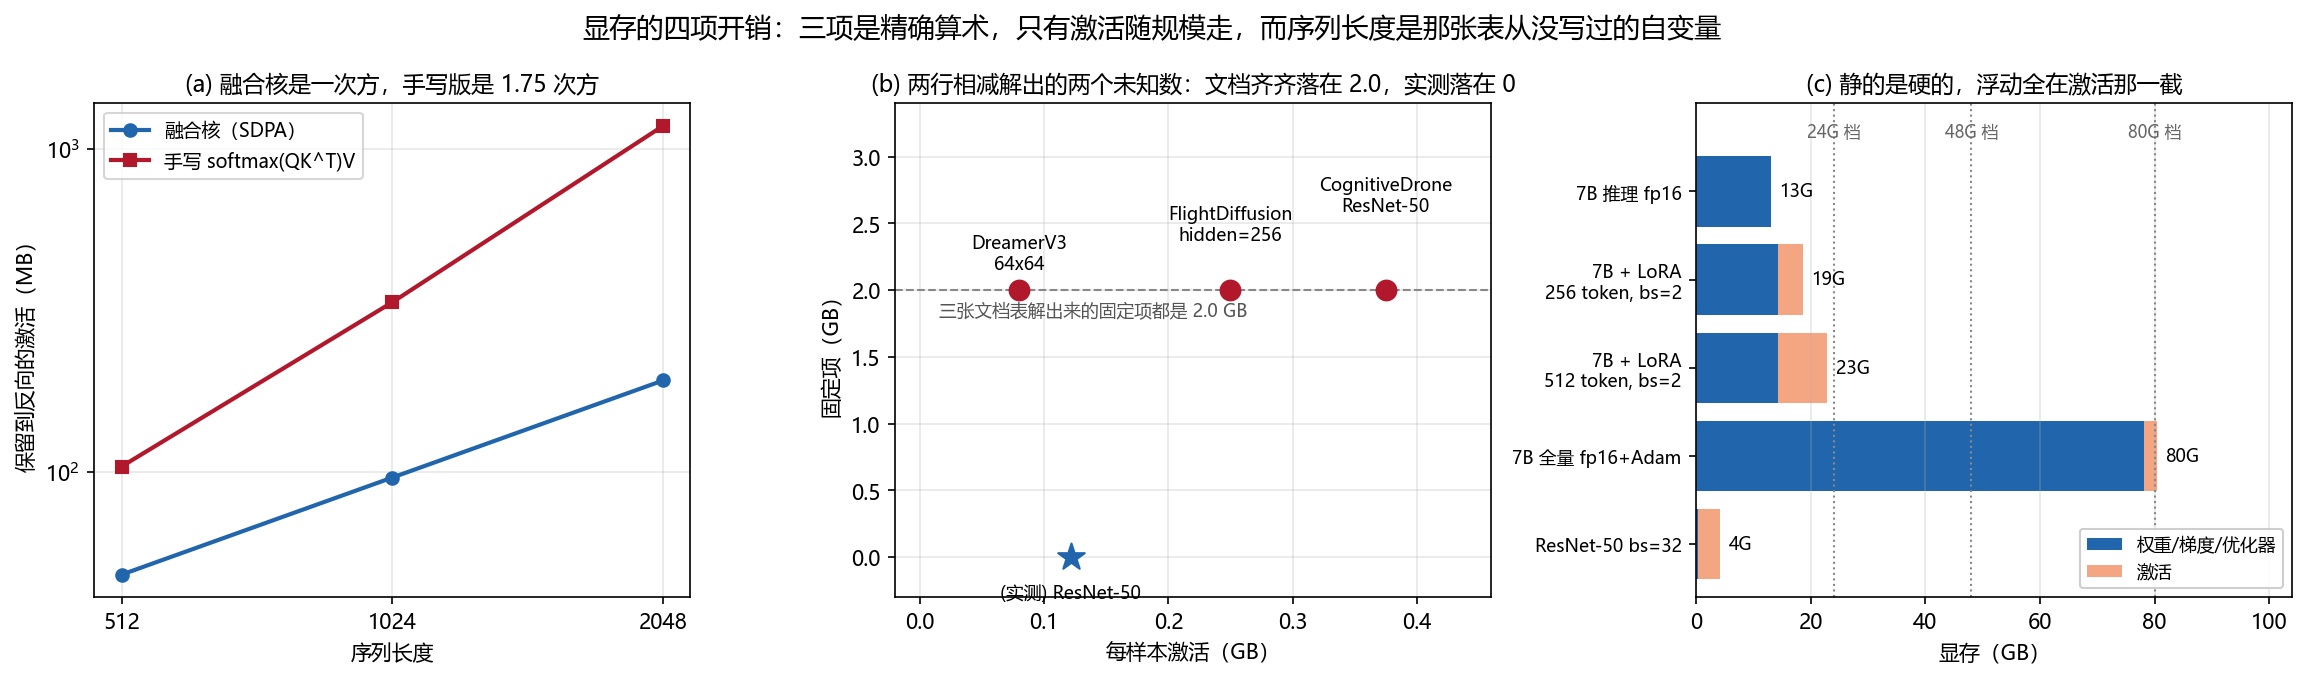
6.4 只给了三个硬数字:3×A100(40 GB)、约 25 小时、全局 batch 不变。但读到这里真正想知道的是另一件事——脚本写的是 per_device_train_batch_size 32 配 model_max_length 2048,一张 40 GB 的卡装得下吗? 这个问题能算,因为显存是四笔账:权重 / 梯度 / 优化器状态 / 激活,前三笔是精确算术。
前三笔:LoRA r=64 的静态账¶
可训练参数要付三份钱(fp16 权重 + fp16 梯度 + fp32 两份动量,12 字节/参数),冻结的只付一份(fp16 权重,2 字节/参数):
GB = 2 ** 30
P = 7.0e9                                  # Vicuna-v1.5-7B 的参数量
def lora_params(r, d=4096, layers=32, targets=7):
    """q/k/v/o/gate/up/down 七个模块,每个挂一对 A(r,d) 与 B(d,r),加在冻结权重之上。"""
    return layers * targets * 2 * d * r
def static_gb(n_frozen, n_trainable):
    """冻住的只占 fp16 权重;可训练的还要加 fp16 梯度与两份 fp32 Adam 动量。"""
    return (2 * n_frozen + 12 * n_trainable) / GB
print("配置                     权重     梯度    Adam     合计")
for r in (0, 16, 64, 128):
    tr, fro = (lora_params(r), P) if r else (P, 0)   # LoRA 加在冻结权重之上,不是替换
    w, g, o = 2 * (fro + tr) / GB, 2 * tr / GB, 8 * tr / GB
    print(f"{'全量' if not r else f'LoRA r={r}':<22} {w:>5.1f}G {g:>6.1f}G {o:>6.1f}G {w + g + o:>7.1f}G")
per_tok = 8.5 * 2 ** 20                    # 实测:7B / 32 层 / d=4096,每 token 的激活
need_tok = 32 * 2048                       # 每卡 batch 32 x 序列 2048
budget = 40.0 - static_gb(P, lora_params(64))   # 40 GB 卡减去静态账
print(f"\n每卡静态(r=64)= {static_gb(P, lora_params(64)):.1f}G,"
      f"40G 卡留给激活 {budget:.1f}G")
print(f"每卡需要激活 {need_tok * per_tok / GB:.0f}G({need_tok} token x 8.5 MB),"
      f"超预算 {need_tok * per_tok / GB / budget:.0f} 倍")
本地实测结果¶
配置                     权重     梯度    Adam     合计
全量                      13.0G   13.0G   52.2G    78.2G
LoRA r=16               13.1G    0.1G    0.2G    13.4G
LoRA r=64               13.3G    0.2G    0.9G    14.4G
LoRA r=128              13.5G    0.4G    1.8G    15.7G
每卡静态(r=64)= 14.4G,40G 卡留给激活 25.6G
每卡需要激活 544G(65536 token x 8.5 MB),超预算 21 倍
第一,LoRA 省下的是优化器状态,而且是压倒性的。 权重那一列从 13.0 GB 只涨到 14.4 GB —— 因为低秩矩阵是加在冻结权重之上的,7B 那 13 GB 一分没少。真正塌下去的是 Adam:52.2 GB → 0.9 GB。r=64 一共只训练 1.17 亿参数(1.68%),所以静态账几乎是「7B 权重本身」这一项。
第二,静态账怎么算都装得下,装不下的是激活。 14.4 GB 对 40 GB 余量很足;但 batch 32 × 2048 token = 65536 token 按测得那把尺子要 544 GB,超预算 21 倍。这个缺口不可能靠调 LoRA 秩或换优化器补上——两笔账是独立的。这正是脚本里 --gradient_checkpointing True 存在的算术理由:不重算就放不下。也就是说,这个仓库为什么没给「每种配置要多少显存」的表,答案在这里——那个数取决于一个开关,不取决于模型本身。
第三,反过来说:齐不等于真。 假设有这么一张四行的显存表(LoRA r=64, bs=2 → 18 GB 等,其中两行是同配置不同卡数)。把有独立数值的那三行拿来对上这把尺子,反解出的序列长度落在 220 / 251 / 213 token,跨度只有 1.2 倍——看起来很齐,像同一套口径量出来的。齐恰恰不能证明它是真的:按配置分行的显存数据在仓库和论文里都不存在,那几个数字无从产生。「自洽」和「有出处」是两件事,这把尺子只能验前者。 判伪的证据来自"这个数在源头根本不存在",不是来自算得通不通。
限制: -
lora_params按 §6.2 的target_modules列出的 7 个投影模块算(q/k/v/o/gate/up/down)。改成只挂 q/v 会小一截;论文写的是 r=64 作用在W_q、W_v上,而代码用的是find_all_linear_names()——论文口径比代码口径更窄,静态账以代码为准更保守。 - 激活那把尺子(8.5 MB/token)在 512 token 上标定;SDPA 融合核在更长序列上仍是一次方,外推安全,手写注意力不是。 - 21 倍这个差额是把梯度检查点关掉算的。开了检查点以后该保留多少,本节没有实测,所以只给方向不给数——不给数,是因为没量过。 - 账面 14.4 GB 不等于nvidia-smi显示 14.4 GB:真机还有框架开销、cuDNN workspace 与显存碎片,那部分不该记在算法需求里。ZeRO-2 还会把梯度与优化器状态按卡数切分,这里算的是不分片的上界。
运行完整脚本¶
参考资源¶
- GeoChat GitHub: https://github.com/mbzuai-oryx/GeoChat
- GeoChat 论文: https://arxiv.org/abs/2311.15826(HTML 全文:https://arxiv.org/html/2311.15826)
- Hugging Face 模型: https://huggingface.co/MBZUAI/geochat-7B
- Hugging Face 数据: https://huggingface.co/datasets/MBZUAI/GeoChat_Instruct
- 仓库文档:
docs/MODEL_ZOO.md(基座与视觉塔)、docs/LoRA.md(训练与合并) - LLaVA-1.5(基座架构): https://arxiv.org/abs/2310.03744
- Vicuna-v1.5(语言塔): https://lmsys.org/blog/2023-03-30-vicuna/
- LoRA 论文: https://arxiv.org/abs/2106.09685
延伸阅读¶
思考题¶
-
架构理解:GeoChat 是怎么把遥感图像接进语言模型的?为什么必须把 CLIP 的位置编码插值到 504,代价是什么?
-
复现卡点:完全照这份指南从零走一遍,最可能在哪两处被挡住?
-
显存规划:一张 40 GB 的卡要跑
per_device_train_batch_size 32配model_max_length 2048,装得下吗?这笔账怎么拆、缺的那部分靠什么补? -
指标选型:要衡量模型对图像中指定区域的定位精度,该看哪类指标?为什么不能用 BLEU-4 代替?
-
排障顺序:微调完发现效果不升反降,文档建议先排查哪几件事?