04 - 复现指南:FlightDiffusion — 条件扩散策略实现与论文更正
预计阅读:12 分钟 | 前置知识:扩散模型基本原理(DDPM/DDIM)、PyTorch 深度学习、FPV 无人机飞行概念
FlightDiffusion 将去噪扩散模型(Denoising Diffusion Model)应用于无人机飞行动作生成,通过条件扩散过程从 FPV 视频观测生成未来飞行轨迹。
注意:截至本文撰写时,FlightDiffusion 的完整代码可能尚未完全开源。本指南基于论文描述和公开信息编写,部分内容可能需要根据实际代码发布进行调整。
更正说明(2026-09 核对该论文原文后补):本指南正文第 2、5 节给出的是一套通用的条件扩散策略实现——条件 U-Net 直接对动作序列去噪——这不是 FlightDiffusion 论文的方法。论文原文用扩散模型生成的是视频,动作空间是从生成的视频里反解出来的,详见文末 第 9 节。正文保持原样,作为"扩散策略怎么写"的入门实现仍然成立,但不要把它当成该论文的复现。
目录
1. 项目概述
- 核心思想: 将无人机轨迹预测建模为条件扩散过程——给定当前视觉观测和历史轨迹,通过迭代去噪生成未来的飞行动作序列。
- 关键创新:
- 将扩散模型的去噪过程与飞行动作空间对齐
- 支持多模态轨迹生成(同一观测下可以生成多条合理轨迹)
- 利用 FPV 视频的时序信息提升预测精度
与其他方法的对比
| 方法 | 范式 | 确定性/随机性 | 多模态能力 |
|---|---|---|---|
| BC (行为克隆) | 直接回归 | 确定性 | 无 |
| CVAE | 变分推断 | 随机 | 有限 |
| FlightDiffusion | 扩散去噪 | 随机 | 强 |
2. 方法原理
2.1 扩散模型基础
扩散模型包含两个过程:
前向过程(加噪):逐步向数据添加高斯噪声
反向过程(去噪):学习从噪声中恢复数据
# 由当前噪声样本估计 x_0
x0_pred = (x_t - sqrt(1 - alpha_bar_t) * eps_theta(x_t, t, c)) / sqrt(alpha_bar_t)

# DDIM 确定性更新
x_{t-1} = sqrt(alpha_bar_{t-1}) * x0_pred + sqrt(1 - alpha_bar_{t-1}) * eps_theta(x_t, t, c)
注意:上式中的 alpha_bar_t = prod(alpha_1 ... alpha_t) 是累积乘积,不是单步的 alpha_t。把两者混用是扩散模型实现中最常见的错误之一,会让采样结果完全失真——排错时可优先检查这里。
2.2 FlightDiffusion 的条件扩散
在飞行动作生成场景中:
- 数据 x: 未来飞行轨迹片段
a_{t:t+H},H 为预测步长 - 条件 c: 当前视觉观测
I_t+ 历史轨迹a_{t-K:t} - 网络 eps_theta: 条件 U-Net 或 Transformer,预测噪声
2.3 推理过程
1. 采样纯噪声 x_T ~ N(0, I)
2. for t = T, T-1, ..., 1:
3.     预测噪声 eps_theta(x_t, t, c)
4.     执行去噪步骤得到 x_{t-1}
5. 输出 x_0 = 预测的飞行轨迹
3. 环境配置
3.1 基础环境
# 创建环境
conda create -n flightdiff python=3.10 -y
conda activate flightdiff

# 安装 PyTorch
pip install torch==2.1.2 torchvision==0.16.2 --index-url https://download.pytorch.org/whl/cu121

# 安装扩散模型相关包
pip install diffusers>=0.25.0
pip install transformers
pip install accelerate
3.2 项目特定依赖
# 克隆仓库(如果已开源)
git clone https://github.com/<author>/FlightDiffusion.git
cd FlightDiffusion
pip install -r requirements.txt

# 主要依赖可能包括:
# - diffusers: 扩散模型框架
# - einops: 张量操作
# - rotary-embedding-torch: 旋转位置编码
# - ema-pytorch: 指数移动平均
3.3 数据处理依赖
pip install av              # 视频解码
pip install opencv-python   # 图像处理
pip install albumentations  # 数据增强
pip install h5py            # 数据存储
4. 数据准备
4.1 FPV 飞行视频数据
FlightDiffusion 需要带有轨迹标注的 FPV 飞行视频数据。数据来源可能包括:
- 自采集的 FPV 飞行数据(通过仿真或真实飞行)
- 公开的 FPV 竞速数据集
- AirSim / PX4 仿真生成的数据
4.2 数据格式
data/
├── videos/
│   ├── flight_001.mp4       # FPV 视频
│   ├── flight_002.mp4
│   └── ...
├── trajectories/
│   ├── flight_001.hdf5      # 对应轨迹(位姿序列)
│   ├── flight_002.hdf5
│   └── ...
└── metadata.json            # 元数据(场景、天气等)
轨迹数据格式(每个时间步):
{
    "position": [x, y, z],        # 世界坐标系位置(米)
    "orientation": [qw, qx, qy, qz],  # 四元数姿态
    "velocity": [vx, vy, vz],     # 速度(米/秒)
    "angular_velocity": [wx, wy, wz],  # 角速度(弧度/秒)
    "timestamp": 0.033            # 时间戳(秒)
}
4.3 数据预处理脚本
# 从视频和轨迹文件生成训练数据
python scripts/preprocess_data.py \
    --video_dir data/videos \
    --traj_dir data/trajectories \
    --output_dir data/processed \
    --context_frames 5 \
    --prediction_horizon 10 \
    --image_size 224
预处理后的数据格式:
data/processed/
├── train/
│   ├── samples_000000.hdf5
│   └── ...
└── val/
    ├── samples_000000.hdf5
    └── ...
每个样本包含:
context_images: 上下文帧 (5, 3, 224, 224)context_actions: 历史动作 (5, 4)target_actions: 未来动作 (10, 4) — 训练目标condition_embedding: 条件嵌入向量
5. 模型架构
5.1 条件 U-Net 扩散网络
"""
FlightDiffusion 条件 U-Net 架构概览(非完整代码)
"""
import torch
import torch.nn as nn

class ConditionalUNet(nn.Module):
    def __init__(self, action_dim=4, horizon=10, hidden_dim=256):
        super().__init__()
        self.action_dim = action_dim   # 供 forward 里 reshape 使用,避免硬编码
        self.horizon = horizon

        # 时间步嵌入
        self.time_embed = SinusoidalPosEmb(hidden_dim)
        self.time_mlp = nn.Sequential(
            nn.Linear(hidden_dim, hidden_dim * 4),
            nn.SiLU(),
            nn.Linear(hidden_dim * 4, hidden_dim)
        )

        # 条件编码器(视觉 + 历史动作)
        self.vision_encoder = VisionEncoder(output_dim=hidden_dim)
        self.action_encoder = nn.Linear(action_dim * 5, hidden_dim)  # 5 帧历史

        # 条件融合
        self.condition_proj = nn.Linear(hidden_dim * 3, hidden_dim)

        # U-Net 去噪网络
        self.down_blocks = nn.ModuleList([
            DownBlock(hidden_dim, hidden_dim * 2),
            DownBlock(hidden_dim * 2, hidden_dim * 4),
        ])
        self.mid_block = MidBlock(hidden_dim * 4)
        self.up_blocks = nn.ModuleList([
            UpBlock(hidden_dim * 4, hidden_dim * 2),
            UpBlock(hidden_dim * 2, hidden_dim),
        ])

        # 输出头:预测噪声
        self.output = nn.Linear(hidden_dim, action_dim * horizon)

    def forward(self, x_t, t, context_images, context_actions):
        """
        x_t: (B, horizon, action_dim) 带噪轨迹
        t: (B,) 时间步
        context_images: (B, 5, 3, 224, 224) 上下文帧
        context_actions: (B, 5, action_dim) 历史动作
        """
        # 编码条件
        t_emb = self.time_mlp(self.time_embed(t))
        v_feat = self.vision_encoder(context_images)
        a_feat = self.action_encoder(context_actions.flatten(1))
        condition = self.condition_proj(torch.cat([t_emb, v_feat, a_feat], dim=-1))

        # U-Net 前向
        h = x_t
        for down in self.down_blocks:
            h = down(h, condition)
        h = self.mid_block(h, condition)
        for up in self.up_blocks:
            h = up(h, condition)

        # 预测噪声
        eps_pred = self.output(h)
        return eps_pred.view(-1, self.horizon, self.action_dim)
5.2 视觉编码器
使用预训练的 ResNet-50 或 CLIP 视觉编码器提取特征:
from torchvision import models

class VisionEncoder(nn.Module):
    def __init__(self, output_dim=256):
        super().__init__()
        # 新版 torchvision 用 weights= 传预训练权重;
        # 旧的 pretrained=True 已废弃,会在未来版本移除
        self.backbone = models.resnet50(weights=models.ResNet50_Weights.DEFAULT)
        self.backbone.fc = nn.Linear(2048, output_dim)
        # 对多帧取平均池化
        self.temporal_pool = nn.AdaptiveAvgPool1d(1)

    def forward(self, images):
        # images: (B, 5, 3, 224, 224)
        B, T = images.shape[:2]
        x = images.flatten(0, 1)  # (B*5, 3, 224, 224)
        feat = self.backbone(x)   # (B*5, 256)
        feat = feat.view(B, T, -1)  # (B, 5, 256)
        feat = self.temporal_pool(feat.transpose(1, 2)).squeeze(-1)  # (B, 256)
        return feat
6. 训练流程
6.1 训练配置
# configs/train_diffusion.yaml
model:
  action_dim: 4
  prediction_horizon: 10
  context_frames: 5
  hidden_dim: 256

diffusion:
  num_timesteps: 1000           # 扩散步数
  beta_schedule: "cosine"       # 噪声调度
  prediction_type: "epsilon"    # 预测噪声还是 x_0

training:
  num_epochs: 200
  batch_size: 64
  learning_rate: 1.0e-4
  ema_decay: 0.9999
  gradient_clip: 1.0
6.2 启动训练
python train.py --config configs/train_diffusion.yaml \
    --data_dir data/processed \
    --output_dir checkpoints \
    --wandb_project flightdiffusion
6.3 训练关键步骤
"""
训练循环概览(非完整代码)
"""
import torch.nn.functional as F

def train_step(model, batch, noise_scheduler):
    context_images = batch["context_images"]
    context_actions = batch["context_actions"]
    target_actions = batch["target_actions"]
    B = target_actions.shape[0]        # 批次大小从数据本身取,不要写成外部变量

    # 1. 采样随机时间步
    t = torch.randint(0, noise_scheduler.num_timesteps, (B,))

    # 2. 向目标轨迹添加噪声
    noise = torch.randn_like(target_actions)
    x_t = noise_scheduler.add_noise(target_actions, noise, t)

    # 3. 模型预测噪声
    noise_pred = model(x_t, t, context_images, context_actions)

    # 4. 计算损失
    loss = F.mse_loss(noise_pred, noise)
    return loss
6.4 训练资源需求
| 配置 | GPU 显存 | 训练时间(估计) |
|---|---|---|
| hidden=256, batch=32 | ~10 GB | ~24 小时 |
| hidden=256, batch=64 | ~18 GB | ~12 小时 |
| hidden=512, batch=32 | ~20 GB | ~36 小时 |
7. 推理与评估
7.1 推理
python inference.py \
    --model_path checkpoints/best_model.pt \
    --video_path test_flight.mp4 \
    --output_path results/predicted_trajectory.json \
    --num_samples 10 \
    --ddim_steps 50
推理参数说明:
| 参数 | 说明 |
|---|---|
num_samples |
从不同随机噪声采样生成的轨迹数量 |
ddim_steps |
DDIM 加速采样步数(越少越快,质量可能下降) |
guidance_scale |
条件引导强度(类似 Classifier-Free Guidance) |
7.2 评估指标
| 指标 | 说明 |
|---|---|
| Position Error (PE) | 预测轨迹位置的平均欧氏误差(米) |
| Orientation Error (OE) | 预测姿态的角度误差(度) |
| ADE | 平均位移误差 |
| FDE | 最终点位移误差 |
| Diversity | 多条采样轨迹的多样性(米) |
| Collision Rate | 仿真中的碰撞率 |
7.3 评估脚本
python evaluate.py \
    --model_path checkpoints/best_model.pt \
    --test_data data/processed/val \
    --output_dir results/evaluation \
    --num_samples 20
8. 常见问题与解决方案
Q1: 训练初期 loss 不下降
扩散模型的训练损失(MSE)在初期可能波动较大,这是正常现象。如果持续不下降:
- 检查数据归一化是否正确(动作值应在合理范围内)
- 确认时间步采样是否均匀
- 尝试使用
linearbeta schedule 而非cosine
Q2: 推理速度太慢
# 方法 1: 减少 DDIM 步数
python inference.py --ddim_steps 20  # 从 1000 降到 20

# 方法 2: 使用 DDIM 而非 DDPM
# 方法 3: 使用 DPM-Solver 加速
Q3: 生成轨迹不平滑
- 在推理后应用简单平滑滤波(如 Savitzky-Golay 滤波)
- 增加扩散步数以提高生成质量
- 检查训练数据中轨迹是否存在突变
Q4: 多模态生成的轨迹过于相似
- 增大
guidance_scale以增强条件引导 - 使用 Classifier-Free Guidance 训练
- 增加采样数量以探索更多模态
Q5: 显存不足
# 使用 gradient checkpointing
# 使用 mixed precision (fp16/bf16)
# 减小 batch_size
# 使用 DeepSpeed ZeRO Stage 2
9. 论文原文的做法:视频生成而非动作生成
本节依 arXiv:2509.14082 v2 全文补写,用于校正前面第 1、2、5 节对论文方法的描述。论文作者来自 Skolkovo 的 Intelligent Space Robotics Laboratory。
9.1 真实的管线:三阶段,输入是一帧
论文的输入是机载相机拍下的单张 RGB 图像,不是视频序列:
| 阶段 | 用什么 | 产出 |
|---|---|---|
| ① 视觉推理与任务规划 | Gemini 2.5 Flash(Google DeepMind 的多模态 VLM)+ 结构化自然语言提示 | 一段高层指令文本 |
| ② 视频生成 | Wan 2.2 I2V Fast(图生视频) | 一段 FPV 视频,单条耗时约 20–60 s |
| ③ 轨迹重建 | ORB-SLAM3(单目模式)做视觉里程计 | 3D 轨迹、速度、位姿、加速度 |
重建出的轨迹是一串 SE(3) 位姿,转成速度指令下发给飞控;同时这些 state-action 对构成监督数据集,用来训下游策略。长时任务按"推理 → 视频生成 → 路径规划 → 执行"分段推进。
与正文的关键差别:扩散模型在这里是视频生成器,不是动作去噪器。论文自己的说法是 "video diffusion model generates future frames and their corresponding action spaces"——动作空间是生成视频的副产品,由视觉里程计反解得到,而不是在动作空间上做去噪。
9.2 论文报告的量化结果
| 指标 | 数值 |
|---|---|
| 位置误差 | 均值 0.25 m(RMSE 0.28 m) |
| 朝向误差 | 均值 0.19 rad(RMSE 0.24 rad) |
| 长时任务(真机) | 5 分 20 秒完成,均速约 1 m/s;仿真 4 分钟;单条视频生成约 30 s |
| 仿真 vs 真机 | 成功率 M = 0.628 (SD 0.162) vs M = 0.617 (SD 0.177),双向 ANOVA F(1,16) = 0.394, p = 0.541,无显著差异 |
仿真在 Gazebo 的 small city world 里做;每类机动(前飞、隧道穿行、避障、降落)在仿真与真机各执行 20 次。注意最后一行的正确读法是"没测出差异",不是"真机表现更好"——p = 0.541 意味着这个样本量下两者无法区分。
9.3 论文自己承认的局限
- 生成帧里会出现真实环境中不存在的物体(hallucination),论文称这是扩散生成模型的预期局限
- 与 Vicon 动捕真值比对存在小的朝向偏差 Δθ
- 长时任务会累积误差(compounding errors),需要按子任务分段规划
- 单目 ORB-SLAM3 提供轨迹可靠,但完整建图与重定位能力受限
9.4 那正文第 2–7 节还有用吗
有用,但用途要改口径:
| 本文正文 | 论文原文 |
|---|---|
| 条件 U-Net 对动作序列去噪 | 图生视频模型生成视频帧 |
| 输入 5 帧上下文 + 历史动作 | 输入单帧 + 文本提示 |
输出 (B, horizon, action_dim) 动作块 |
输出视频 → SLAM 反解轨迹 |
| 自己训(有数据就能跑、不依赖外部 API) | 依赖 Gemini / Wan 2.2 等外部大模型 API |
也就是说:正文第 2–7 节是一套学扩散策略的完整练习(自己写模型、自己训、自己采样),而论文是用现成大模型搭系统(它并不训练自己的扩散模型)。两条路线都值得学,但重点完全不同——想复现论文,功夫花在 VLM 提示工程和 SLAM 接口调通上,而不是训条件 U-Net。
动手验证:6.4 里调 hidden_dim,为什么调不动显存?
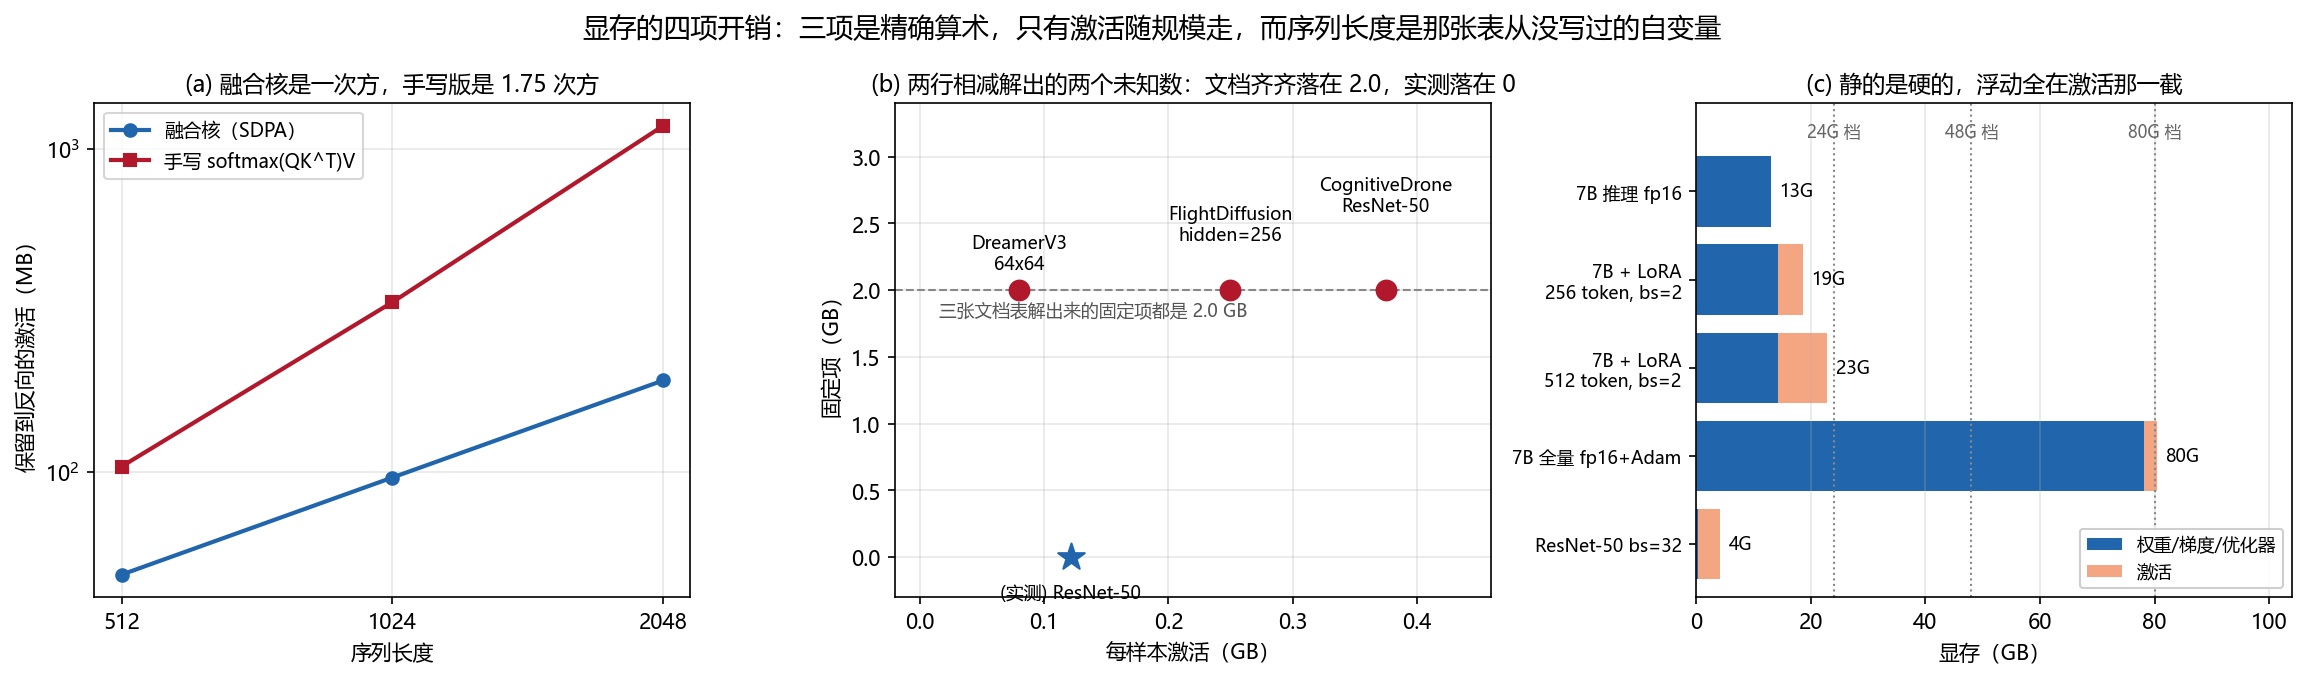
6.4 那张表有三行,其实动了两个自变量:前两行只动 batch(32→64),第三行动了 hidden_dim(256→512),batch 回到 32。前两行能解——每样本 0.25 GB、固定项 2.00 GB,和 01-环境搭建 里那三张表解出来的是同一个 2.00。
第三行是这张表真正的断言:hidden_dim 翻倍,显存从 10 GB 涨到 20 GB。这个断言可以单独验,因为 hidden_dim 只是动作头的宽度,而这个模型有两个部分:动作头(第 5 节的 ConditionalUNet)和视觉编码器(5.2 的 VisionEncoder)。编码器每帧都要过一次 ResNet-50,而 context_frames=5 意味着一次前向要处理 5 × batch 张 224x224 的图。
把两部分拆开量
import torch, torch.nn as nn, torchvision
GB = 2 ** 30
def activation_bytes(m, x):        # 只数激活;参数按 storage 指针剔掉
    ps = {p.untyped_storage().data_ptr() for p in m.parameters()}
    tot = [0]
    def pack(t):
        if t.untyped_storage().data_ptr() not in ps:
            tot[0] += t.numel() * t.element_size()
        return t
    with torch.autograd.graph.saved_tensors_hooks(pack, lambda t: t):
        m(x).sum()
    return tot[0] / GB
class Head(nn.Module):             # 6.1 的动作扩散头:10 步 x 4 维,DiT 式 6 层
    def __init__(self, hidden, layers=6):
        super().__init__()
        self.inp = nn.Linear(4, hidden)
        self.temb = nn.Linear(256, hidden)
        self.blocks = nn.TransformerEncoder(
            nn.TransformerEncoderLayer(hidden, 8, 4 * hidden, batch_first=True, dropout=0.0),
            num_layers=layers)
        self.out = nn.Linear(hidden, 4)
    def forward(self, x):
        h = self.inp(x) + self.temb(torch.zeros(x.shape[0], 256)).unsqueeze(1)
        return self.out(self.blocks(h))
class Encoder(nn.Module):          # 5.2 的视觉编码器:ResNet-50 换掉 fc
    def __init__(self):
        super().__init__()
        self.backbone = torchvision.models.resnet50(weights=None)
        self.backbone.fc = nn.Linear(2048, 256)
    def forward(self, x):
        return self.backbone(x)
torch.manual_seed(0)
head_gb = {}
for hidden in (256, 512):
    head_gb[hidden] = activation_bytes(Head(hidden), torch.randn(32, 10, 4, requires_grad=True))
    print(f"动作头 hidden={hidden:<4} 激活 bs=32 {head_gb[hidden]:>6.3f}G")
enc = Encoder()
a32 = activation_bytes(enc, torch.randn(32 * 5, 3, 224, 224, requires_grad=True))
a64 = activation_bytes(enc, torch.randn(64 * 5, 3, 224, 224, requires_grad=True))
print(f"编码器     32x5 帧 {a32:>6.2f}G   64x5 帧 {a64:>6.2f}G   每样本 {a32 / 32:>6.3f}G")
print(f"动作头占编码器的 {head_gb[256] / a32:.2%}")
本地实测结果
动作头 hidden=256  激活 bs=32  0.032G
动作头 hidden=512  激活 bs=32  0.063G
编码器     32x5 帧  19.43G   64x5 帧  38.85G   每样本  0.607G
动作头占编码器的 0.16%
hidden_dim 从 256 到 512,动作头确实翻倍了:0.032 GB → 0.063 GB。但动作头只占编码器的 0.16%。 它翻倍给总量加了 0.03 GB,而同一行里编码器那一项一动没动、还是 19.43 GB。
所以 6.4 第三行的 10 GB → 20 GB 不可能是 hidden_dim 造成的:这个变量的全部杠杆只有 0.03 GB。三行真正的差别在 batch(编码器是 5 × batch 张图,每样本 0.607 GB),而第三行恰好把 batch 调回了 32,于是它和第一行应该几乎一样——表里却是 10 和 20。
要省显存,杠杆不在 hidden_dim。 按大小排:把编码器冻住(requires_grad_(False) 加 no_grad)能让它的激活直接归零,只剩动作头那 0.03 GB;其次是 context_frames,它和显存是严格的正比(0.607 GB/样本 ÷ 5 帧 = 0.121 GB/帧);再其次是输入分辨率,ResNet-50 的激活和 H × W 成正比。hidden_dim 排在最后。
限制:这里量的是 PyTorch eager 模式保留到反向的激活,不含 cuDNN workspace、显存碎片和 CUDA context;编码器按 5.2 的写法用的是可训练的
ResNet50_Weights.DEFAULT,没有冻结。真机上数字会更大,所以 6.4 那张表的hidden=256, batch=64(~18 GB)在 24 GB 卡上未必放得下——编码器一项实测就是 38.85 GB。思考题 4 的前提「三档在 24 GB 的卡上都放得下」,只在编码器被冻结时成立。
运行完整脚本
参考资源
- FlightDiffusion 论文(本指南对应的论文): https://arxiv.org/abs/2509.14082
- DDPM 论文: https://arxiv.org/abs/2006.11239
- DDIM 论文: https://arxiv.org/abs/2010.02502
- Diffusers 文档: https://huggingface.co/docs/diffusers
- Diffuser (Planning with Diffusion): https://arxiv.org/abs/2205.09991
延伸阅读
思考题
-
复现起点:把开头的"注意"和 3.2 节的克隆命令放在一起看,照这份指南动手,最早会在哪一步卡住?
-
排错优先级:采样出来的轨迹完全失真,文档明确说应该优先检查哪里?为什么?
-
形状契约:把
preprocess_data.py的--context_frames从 5 改成 8,模型里哪一处必须同步改?为什么? -
显存预算:6.4 节三档配置在 24 GB 的卡上都放得下,该按什么选?真 OOM 时文档又给了哪几条降配手段?
-
评估口径:文档只给了 PE/OE/ADE/FDE/Diversity/Collision Rate 六个指标和 evaluate.py,想拿自己的数字去对齐原论文,缺的是什么?