世界模型发展史:从 Ha/Schmidhuber 到视频世界模型
预计阅读:20 分钟 | 前置知识:深度学习基础、强化学习基本概念、VAE 原理
1. 什么是世界模型?
世界模型(World Model)是智能体对环境动态的内部表征。它允许智能体在"心智模拟"(mental simulation)中预测未来状态,从而在不与真实环境交互的情况下进行规划和决策。对于无人机系统而言,世界模型意味着 UAV 可以在脑海中"预演"飞行轨迹、预测障碍物运动、评估不同机动动作的后果,而无需真正执行这些动作。
这一概念最早可追溯到认知科学领域 Kenneth Craik (1943) 提出的"内部模型"假说,而在人工智能领域,其现代形式的发展始于 2018 年。
graph LR
    A[认知科学<br/>Craik 1943] --> B[控制论<br/>Wiener 1948]
    B --> C[强化学习<br/>Dyna 1990]
    C --> D[深度世界模型<br/>Ha 2018]
    D --> E[Dreamer 系列<br/>2020-2023]
    D --> F[视频世界模型<br/>2023-2025]
    E --> G[无人机专用<br/>世界模型]
    F --> G
2. 前深度学习时代(1990-2017)
2.1 Dyna 架构(Sutton, 1990)
Richard Sutton 提出的 Dyna 架构是 Model-Based RL 的开山之作。Dyna 的核心思想极为优雅:智能体不仅从真实交互中学习,还利用学到的模型生成虚拟经验进行策略改进。
Dyna 的局限在于它使用表格形式表示模型,无法处理高维连续状态空间。
2.2 线性动力学模型
在深度学习兴起之前,研究者使用线性动力学模型(如卡尔曼滤波、线性时变系统)来建模环境动态。这些方法在无人机的低层控制中有广泛应用(如 PX4 飞控中的 EKF),但在复杂视觉环境中表现有限。
2.3 瓶颈与挑战
| 挑战 | 描述 |
|---|---|
| 维度灾难 | 高维观测(如图像)难以用传统方法建模 |
| 复合误差 | 多步预测的误差累积导致模型不可用 |
| 泛化能力 | 模型难以泛化到未见过的状态 |
| 计算效率 | 实时规划需要高效的模型查询 |
3. 深度世界模型的诞生(2018)
3.1 Ha & Schmidhuber: "World Models"
2018 年,David Ha 和 Jürgen Schmidhuber 发表了 "Recurrent World Models Facilitate Policy Evolution"(NeurIPS 2018;预印本题名 "World Models",arXiv:1803.10122),首次将 VAE 和 RNN 结合构建端到端的世界模型,论文本身用漫画叙事。
架构设计:
graph TB
    subgraph "Vision Model - V"
        A[观测 o_t] -->|Encoder| B[潜在编码 z_t]
        B -->|Decoder| C[重建观测]
    end

    subgraph "Memory - M"
        D[z_t] --> E[RNN/LSTM]
        F[a_t] --> E
        E --> G[隐藏状态 h_t]
    end

    subgraph "Controller - C"
        G --> H[线性控制器]
        I[z_t] --> H
        H --> J[动作 a_t]
    end

    B --> D
    G --> H
三大组件:
| 组件 | 网络结构 | 功能 |
|---|---|---|
| Vision (V) | Convolutional VAE | 将高维图像压缩为低维潜在编码 z |
| Memory (M) | MDN-RNN (混合密度网络 + LSTM) | 预测下一时刻的潜在状态分布 p(z_{t+1}|z_t, a_t, h_t) |
| Controller (C) | 线性层 | 根据 z_t 和 h_t 输出动作 |
关键创新:
- 潜在空间建模:不在像素空间预测,而在 VAE 的潜在空间中预测,大幅降低计算复杂度
- 混合密度网络 (MDN):用高斯混合模型建模状态转移的概率分布,处理环境的随机性
- 在"梦境"中训练:智能体完全在模型生成的虚拟轨迹中训练策略,无需真实环境交互
实验成果:
在 VizDoom 和 Car Racing 两个环境中,Ha 的世界模型实现了: - Car Racing:完全在梦境中训练的策略获得了平均 906 分(满分 1000) - VizDoom:在梦境中训练的策略在真实环境中表现良好
局限性: - MDN-RNN 在长期预测中容易出现误差累积 - 梦境训练存在"模型利用"(model exploitation)问题:策略可能找到模型中的漏洞 - 仅在简单环境中验证
3.2 同期工作:PlaNet
Danijar Hafner 等人在 2018 年底挂出预印本、2019 年在 ICML 正式发表 PlaNet(Deep Planning Network,arXiv:1811.04551),进一步推进了深度世界模型的研究。PlaNet 引入了:
- 循环状态空间模型 (RSSM):结合确定性路径和随机性路径,更准确地建模环境动态
- 潜在动态预测:在潜在空间中进行多步预测
- CEM 规划:使用交叉熵方法 (Cross-Entropy Method) 在模型中搜索最优动作序列
PlaNet 的 RSSM 架构成为后续 Dreamer 系列的基础。
4. Dreamer 系列:世界模型的三次飞跃(2020-2023)
Dreamer 系列由 Danijar Hafner 领导,是世界模型研究最具影响力的系列工作,每一版都在架构设计和训练范式上有重大突破。
4.1 DreamerV1(2020)
论文: "Dream to Control: Learning Behaviors by Latent Imagination"(ICLR 2020,arXiv:1912.01603)
DreamerV1 在 PlaNet 的基础上增加了行为学习模块,实现了端到端的"想象-决策"流水线。
核心架构:
graph TB
    subgraph "世界模型 World Model"
        A[观测 o_t] -->|CNN Encoder| B[潜在状态 s_t]
        B -->|RSSM| C[s_{t+1} 预测]
        C -->|Reward Head| D[奖励预测 r_t]
        C -->|Continue Head| E[终止预测 c_t]
        C -->|Decoder| F[观测重建]
    end

    subgraph Actor-Critic
        C -->|想象轨迹| G[Actor 网络]
        G --> H[动作 a_t]
        C -->|想象轨迹| I[Critic 网络]
        I --> J[价值估计 V]
    end

    J -->|梯度更新| G
RSSM 的双路径设计:
| 路径 | 功能 | 优势 |
|---|---|---|
| 确定性路径 h_t | GRU 递归更新,捕捉时序依赖 | 短期预测准确 |
| 随机路径 s_t | 随机变量,建模环境不确定性 | 处理多模态未来 |
| 融合 | h_t 和 s_t 拼接作为完整状态 | 兼顾确定性与随机性 |
关键成果: - 在 DeepMind Control Suite 的 20 个连续控制任务中,平均性能超过 model-free 方法(如 D4PG) - 证明纯想象训练(imagination training)可以在长时程视觉控制任务中产生有效策略 - 论文另在 Atari 的一个离散动作子集上做了实验,并明确指出纯世界模型方法在这些域尚不具竞争力
4.2 DreamerV2(2021)
论文: "Mastering Atari with Discrete World Models"(ICLR 2021,arXiv:2010.02193)
DreamerV2 的核心创新是离散化表征,用分类分布(categorical distribution)替代连续高斯分布。
架构改进:
离散表征的优势:
| 方面 | 连续表征 (V1) | 离散表征 (V2) |
|---|---|---|
| 模式覆盖 | 容易模式坍缩 | 更好的多样性 |
| 多模态建模 | 困难 | 自然支持 |
| 计算效率 | 需要重参数化 | 直接采样 |
| 与 Transformer 兼容性 | 较差 | 天然兼容 |
突破性成果: - 在 Atari 200M 基准上,首次以世界模型方法超越人类中位数水平 - 论文另在连续动作域(humanoid 站立与行走)上验证,但正文未主张 DMControl 免调参 - 证明离散表征在世界模型中的优越性
4.3 DreamerV3(2023)
论文: "Mastering Diverse Domains through World Models"(arXiv:2301.04104,2023;后发表于 Nature 2025)
DreamerV3 是该系列的巅峰之作,实现了单一算法、固定超参数跨域泛化。
核心创新:
- Symlog 预测:对观测和奖励使用对称对数变换,统一不同尺度的信号
- 自由比特正则化 (Free Bits):防止 KL 散度崩溃为零,确保表征的信息量
- 稳健的优化器组合:自适应梯度裁剪(AGC)+ LaProp(RMSProp 后接动量),避免 Adam 在跨域尺度下的偶发不稳定。注:论文的尺度鲁棒性主因是 symlog 与奖励的百分位归一化,优化器是配套项。
# Symlog 变换(概念代码)
def symlog(x):
    return torch.sign(x) * torch.log(1 + torch.abs(x))

def symexp(x):
    return torch.sign(x) * (torch.exp(torch.abs(x)) - 1)
DreamerV3 的统一能力:
| 领域 | 任务数 | 表现 |
|---|---|---|
| Proprio Control | 18 | 达到 SOTA |
| Visual Control | 20 | 达到 SOTA |
| Atari | 57 | 超过 MuZero / Rainbow / IQN |
| Minecraft | 12 个里程碑道具 | 从零开始收集钻石 |
| ProcGen / DMLab / BSuite | 16 / 30 / 23 | 单一超参数跨域 |
| Atari100k | 26 | 低预算档 |
对无人机研究的启示:
DreamerV3 的跨域能力使其成为无人机世界模型的有力候选。其固定超参数特性意味着无需针对每个飞行场景单独调参,这对 UAV 应用尤为重要——不同任务(悬停、跟踪、避障)的动力学差异巨大。
5. TD-MPC 系列:模型预测控制的复兴(2022-2023)
5.1 TD-MPC(2022)
论文: "Temporal Difference Learning for Model Predictive Control"(ICML 2022,arXiv:2203.04955)
TD-MPC 由 Nicklas Hansen 等人提出,将时序差分学习(TD Learning)与模型预测控制(MPC)结合。
核心思路:
关键组件:
| 组件 | 作用 |
|---|---|
| Encoder h(o) | 将观测编码为潜在状态 |
| Latent Dynamics Model d(z, a) | 预测下一状态 |
| Reward Prediction r(z, a) | 预测即时奖励 |
| Terminal Value Q(z, a) | 估计长期价值(TD 目标) |
TD-MPC 的独特之处:
- 不需要解码器:不重建观测,只关注对决策有用的信息
- 联合训练:编码器、动态模型和价值函数联合优化
- CEM 规划:在潜在空间中使用交叉熵方法搜索最优动作序列
5.2 TD-MPC2(2023)
论文: "TD-MPC2: Scalable, Robust World Models for Continuous Control"(ICLR 2024,arXiv:2310.16828)
TD-MPC2 将 TD-MPC 扩展到: - 104 个任务(跨 DMControl、Meta-World、ManiSkill2、MyoSuite) - 单一模型处理多个任务 - 参数量从 1M 扩展到 300M+
6. 视频世界模型的崛起(2023-2025)
随着视频生成模型的快速发展,一种全新的世界模型范式出现了——直接学习视频帧的生成模型,将其作为隐式的世界模型。
6.1 UniSim(2023)
论文: "Learning Interactive Real-World Simulators"(Google DeepMind,ICLR 2024,arXiv:2310.06114)
UniSim 的核心理念:视频生成模型就是世界模型。
graph LR
    A[当前帧] --> B[视频扩散模型]
    C[动作/文本条件] --> B
    B --> D[预测未来帧序列]
    D --> E[作为模拟器<br/>训练机器人策略]
关键特性: - 基于扩散模型(Diffusion Model)的视频预测 - 支持文本和动作条件控制 - 可以模拟真实世界的物理交互 - 用于机器人策略的离线训练
6.2 Cosmos(NVIDIA, 2025)
NVIDIA 的 Cosmos 项目将世界模型定位为物理世界的基础模拟器(arXiv:2501.03575):
- 大规模视频预训练
- 物理一致性约束
- 面向机器人和自动驾驶的应用
- 支持多种条件控制(文本、动作、深度图等)
6.3 Sora 与世界模型的讨论
OpenAI 的 Sora(2024)引发了关于"视频生成模型是否是世界模型"的广泛讨论。Sora 只有技术报告、未挂 arXiv,引用时按技术报告处理:
支持观点: - Sora 能够生成物理上大致合理的视频 - 隐式建模了物体运动、光照变化等物理规律 - 可以作为模拟器的替代
反对观点: - 缺乏精确的物理推理能力 - 无法保证长期一致性 - 没有显式的状态表征,难以进行精确规划
graph TB
    A[世界模型的定义光谱] --> B[严格定义<br/>显式状态 + 动力学 + 规划]
    A --> C[宽松定义<br/>任何能预测未来的模型]
    B --> D[Dreamer / TD-MPC]
    B --> E[NeRF / 3DGS]
    C --> F[UniSim / Sora / Cosmos]
    C --> G[LLM 作为世界模型?]
7. 世界模型发展时间线
| 年份 | 里程碑 | 核心贡献 | 影响 |
|---|---|---|---|
| 1990 | Dyna | 模型辅助强化学习 | 奠定 Model-Based RL 理论基础 |
| 2018 | World Models (Ha) | VAE + RNN + Controller | 首个端到端深度世界模型 |
| 2019 | PlaNet | RSSM + CEM 规划 | 潜在空间规划范式 |
| 2020 | DreamerV1 | RSSM + Actor-Critic 想象训练 | 世界模型可用于行为学习 |
| 2021 | DreamerV2 | 离散表征 | 在 Atari 上超越人类 |
| 2022 | TD-MPC | TD + MPC 联合 | 更高效的规划范式 |
| 2023 | DreamerV3 | 跨域统一算法 | 固定超参数泛化所有领域 |
| 2023 | UniSim | 视频扩散世界模型 | 视频生成 = 世界模型? |
| 2023 | I-JEPA | 表征空间预测,不重建输入 | 与重建派分岔的第三条主线 |
| 2024 | Sora | 大规模视频生成 | 引发世界模型定义讨论 |
| 2024 | TD-MPC2 | 规模化 TD-MPC | 单一模型跨 104 任务 |
| 2024 | V-JEPA | 把联合嵌入预测从图像推到视频 | JEPA 路线获得时序形态 |
| 2025 | Cosmos (NVIDIA) | 物理世界模拟器 | 面向机器人和自动驾驶 |
| 2025 | Dream to Fly | DreamerV3 迁到无人机竞速 | 世界模型用于像素级机动飞行(HIL,上限 9 m/s) |
| 2026 | 世界模型评测成为研究对象 | 孤立审计会误判修复效果、失败不敏感 | 从比分数转向查诊断工具本身 |
| 2026 | 世界模型与动作联合建模 | 双时程世界-动作模型、显式几何建模 | 与 VLA 路线合流 |
8. 无人机领域的世界模型发展
世界模型在 UAV 领域的应用相对较新,但发展迅速:
timeline
    title 无人机世界模型发展
    2022 : 物理引导学习 on SE(3)
         : 基于 Lie 群的无人机动力学建模
    2023 : HDVIO (UZH)
         : 混合深度视觉惯性里程计
    2024 : AeroVerse (中科院空天院)
         : 无人机具身世界模型基准套件
         : 仿真平台 + 数据集 + 评测
    2025 : Dream to Fly (UZH RPG)
         : DreamerV3 无人机竞速
         : ANWM / AirScape
         : 生成式无人机世界模型
无人机世界模型的独特挑战:
| 挑战 | 与通用世界模型的区别 |
|---|---|
| 6-DoF 运动 | 需要在 SE(3) 群上建模,不仅仅是 2D 平面 |
| 快速动态 | 无人机运动速度快,需要高频预测 |
| 感知-动作耦合 | 视觉输入与飞行控制紧密耦合 |
| 安全约束 | 不可行的预测可能导致坠机 |
| 计算资源 | 机载计算能力有限 |
| 环境多样性 | 室内外、城市森林、不同光照条件 |
9. 世界模型的分类体系
根据不同的维度,世界模型可以进行如下分类:
9.1 按表征方式分类
| 类型 | 代表方法 | 优势 | 劣势 |
|---|---|---|---|
| 潜在状态模型 | Dreamer, TD-MPC | 紧凑、高效 | 可能丢失视觉细节 |
| 视频预测模型 | UniSim, Sora | 丰富视觉信息 | 计算成本高 |
| 3D 场景表示 | NeRF, 3DGS | 几何精确 | 难以建模动态物体 |
| 符号/结构化模型 | 场景图 | 可解释性强 | 难以端到端学习 |
9.2 按训练范式分类
| 类型 | 代表方法 | 特点 |
|---|---|---|
| 无监督学习 | VAE-based | 学习环境的压缩表征 |
| 监督学习 | 视频预测 | 直接预测未来观测 |
| 强化学习集成 | Dreamer, TD-MPC | 世界模型与策略联合优化 |
| 基础模型 | Cosmos, UniSim | 大规模预训练,下游适配 |
9.3 对无人机的含义
上面两条轴是通用的,落到无人机上会各自被机载条件改形:
| 轴 | 地面机器人上的样子 | 无人机上被改成什么 |
|---|---|---|
| 表征方式 | 潜空间、视频、3D 表示都能跑 | 机载算力和 8 GB 级显存把「视频生成」压回「潜空间」,视频世界模型只能留在离线或地面站 |
| 训练范式 | 想象训练是主流 | 无人机的高速 6-DoF 动态让「想象」的外推误差放大最快,纯想象训练的策略必须回到真机或高保真仿真上对账 |
| 是否可规划 | 可选 | 不可选:预测要直接进控制回路,误差会被闭环放大,这条硬约束筛掉了大多数只有「好看」而没有「可用状态」的视频世界模型 |
这张表是选型的第一道筛子,不是结论。三条线各自的最新进展分别见 07 评测与诊断、 08 联合嵌入预测与潜空间世界模型、 09 长时程世界模型与交互式生成。
10. 关键论文
-
[NeurIPS'18] World Models — Ha & Schmidhuber
 VAE + RNN, 梦境训练
-
[ICML'19] Learning Latent Dynamics for Planning from Pixels — Hafner et al.
 RSSM, CEM 规划
-
[ICLR'20] Dream to Control — Dream to Control: Learning Behaviors by Latent Imagination
 RSSM + Actor-Critic
-
[ICLR'21] Mastering Atari with Discrete World Models — Hafner et al.
 离散表征
-
[Nature'25] Mastering Diverse Domains through World Models — Hafner et al.
 跨域泛化, Nature 2025 版标题为《Mastering diverse control tasks through world models》
-
[ICML'22] TD-MPC — TD-MPC: Temporal Difference Learning for Model Predictive Control
 TD + MPC
-
[arXiv'23.10] TD-MPC2 — TD-MPC2: Scalable, Robust World Models for Continuous Control
 规模化
-
[arXiv'23.10] UniSim — UniSim: Learning Interactive Real-World Simulators
 视频扩散世界模型
-
[Report'24] Sora — OpenAI
 大规模视频生成
-
[Report'25] Cosmos World Foundation Model Platform for Physical AI — NVIDIA
 物理世界模拟
11. 动手验证:symlog 把"尺度"统一到什么程度?
4.3 节把 symlog 列为 DreamerV3 的第一条核心创新,说它"统一不同尺度的信号",进而支撑起"单一算法、固定超参数"跨域泛化。这句话里的"统一"是可以量的:固定网络、固定学习率,让回归目标的尺度跨三个数量级,看各尺度上分别学成什么样。
11.1 混合尺度的回归任务
四个尺度组(×1 / ×10 / ×100 / ×1000),输入里带上尺度组的 one-hot 标识——网络有足够信息判断量级,学不好就只可能是优化问题,不是容量问题。两次训练逐行对称,唯一变量是损失算在哪个空间。
import torch, torch.nn as nn, torch.nn.functional as F
SCALES, HIDDEN, STEPS, LR = (1., 10., 100., 1000.), 64, 3000, 1e-3
torch.set_num_threads(4)                        # 与 code/h_symlog.py 对齐,线程数会影响浮点求和次序
symlog = lambda x: torch.sign(x) * torch.log1p(x.abs())
symexp = lambda x: torch.sign(x) * torch.expm1(x.abs())
class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(6, HIDDEN), nn.ReLU(),
                                 nn.Linear(HIDDEN, HIDDEN), nn.ReLU(), nn.Linear(HIDDEN, 1))
    def forward(self, x):
        return self.net(x).squeeze(-1)
def make_data(n, seed):
    """u 定幅度与符号,k 定尺度组;x 里两种信息都给全。"""
    g = torch.Generator().manual_seed(seed)
    u = torch.rand(n, generator=g) * 2 - 1
    k = torch.randint(0, 4, (n,), generator=g)
    x = torch.cat([u[:, None], torch.sin(4 * u)[:, None], F.one_hot(k, 4).float()], -1)
    return x, torch.tensor(SCALES)[k] * (u ** 3 + 0.5 * torch.sin(3 * u)), k
def train(mode, x, y, x_ev):
    """raw 直接回归 y;symlog 回归 symlog(y),评估时再还原回原始空间。"""
    torch.manual_seed(0)                        # 两次训练起点完全相同
    net = MLP()
    opt = torch.optim.Adam(net.parameters(), lr=LR)
    for _ in range(STEPS):
        loss = F.mse_loss(net(x), y if mode == "raw" else symlog(y))
        opt.zero_grad(); loss.backward(); opt.step()
    p = net(x_ev).detach()
    return (p if mode == "raw" else symexp(p)).clamp(-3e3, 3e3)
xtr, ytr, _ = make_data(4096, 0)
xte, yte, kte = make_data(2048, 1)
for mode in ("raw", "symlog"):
    pred = train(mode, xtr, ytr, xte)
    rel = [((pred[kte == i] - yte[kte == i]).abs()
            / yte[kte == i].abs().clamp(min=0.05 * s)).mean().item()
           for i, s in enumerate(SCALES)]
    print(f"{mode:<7} 分组相对误差 " + "  ".join(f"x{s:g} {r:6.1%}" for s, r in zip(SCALES, rel))
          + f"   总体 MSE {F.mse_loss(pred, yte).item():6.1f}")
11.2 本地实测结果
各组 |y| 的中位数 0.6 / 6.0 / 62.3 / 606.1(相邻组差 10 倍)

原始空间 MSE(不加 symlog)
  尺度组           相对误差      该组 MSE
  x1         345.3%         0.7
  x10         37.2%         1.8
  x100         1.2%         0.3
  x1000        1.8%       146.1
  总体 MSE       37.4    最差组/最好组  289.9x

symlog 空间 MSE
  尺度组           相对误差      该组 MSE
  x1           3.4%         0.0
  x10          1.0%         0.0
  x100         0.9%         0.5
  x1000        1.8%       217.3
  总体 MSE       54.7    最差组/最好组    3.6x
两件事同时发生,方向相反:
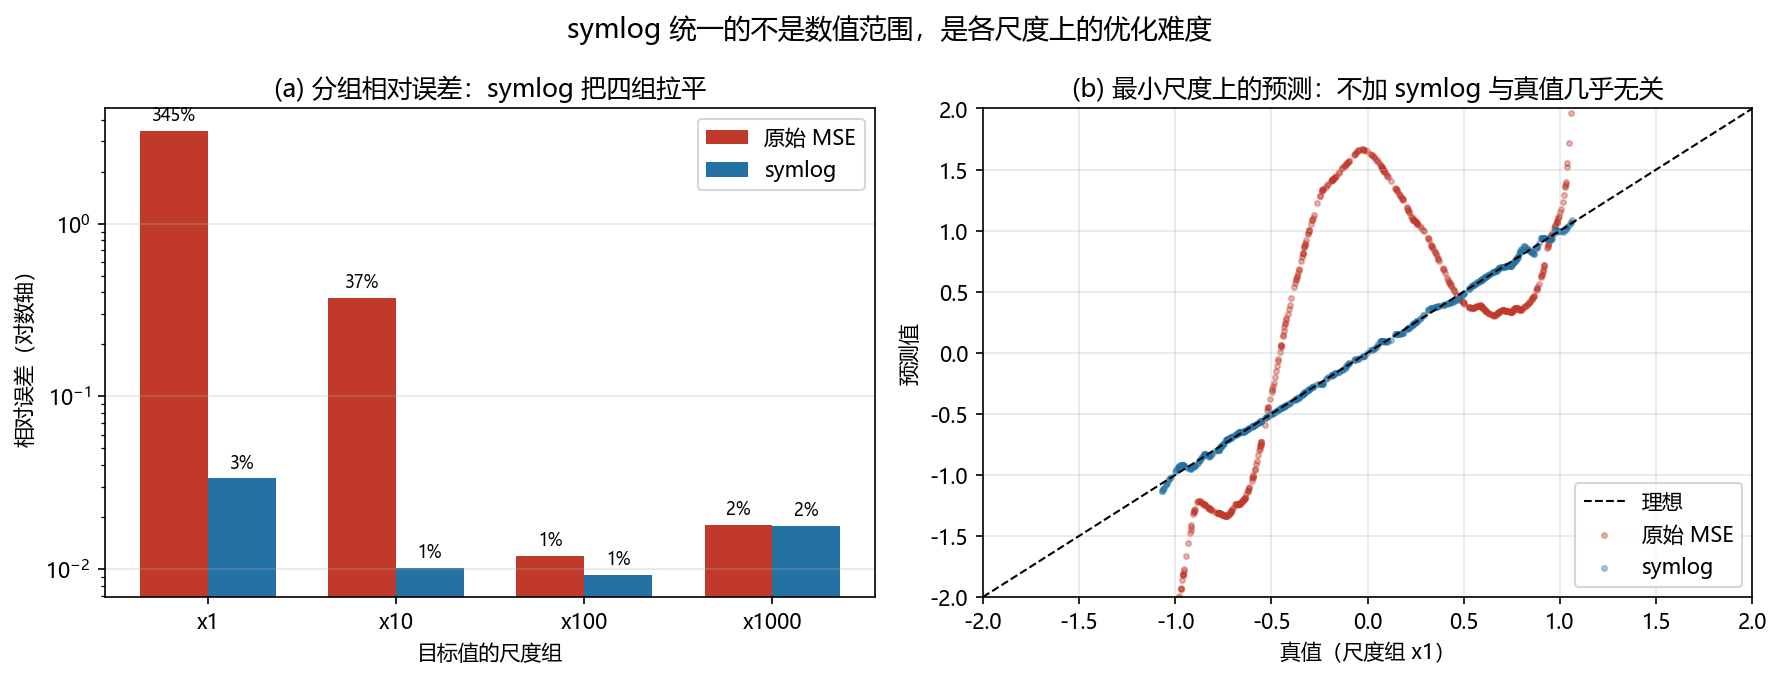
一是分组相对误差的离散度。 不加 symlog 时,×1000 那组相对误差 1.8%,×1 那组 345.3%,最差组是最佳组的 289.9 倍。这不是"小尺度学得慢一点",是压根没学会——左图里那一列红柱随尺度递减,右图更直接:×1 这组的预测值在 [-1.4, 1.7] 之间画出一条与真值无关的曲线,而真值本身只在 [-1.3, 1.3] 之间。加了 symlog 之后,四组相对误差落在 0.9%~3.4%,最差/最佳降到 3.6 倍。
二是总体 MSE 的方向恰好相反。 不加 symlog 的总体 MSE 是 37.4,加了反而涨到 54.7。原因在右图那列 MSE:×1000 那组从 146.1 涨到 217.3。symlog 的对数压缩把大尺度的动态范围也压掉了,大值上的绝对精度必然下降。所以如果一个团队只看总损失曲线,会得出"不加 symlog 更好"的结论——而那个 37.4 里,×1000 一组就贡献了绝大部分,小尺度组的错误被彻底淹没。
这正是 4.3 节那句"统一不同尺度的信号"的实际含义:它统一的不是数值范围,是各尺度在梯度里的权重。不加变换时,平方损失按 y² 加权,尺度差 10 倍意味着梯度差 100 倍,×1000 那组独占整个梯度;symlog 之后各尺度的有效权重量级相当,才谈得上用同一套超参同时照顾到它们。
限制:这里的目标生成是
尺度 × 同一个函数,尺度信息由 one-hot 显式给出,是一个刻意简化的模型。真实跨域任务里尺度与动力学纠缠在一起,symlog 带来的收益不会这么干净。另外相对误差的分母做了|y| ≥ 0.05×尺度的下限截断,避免真值穿过零点时把比值放大;不加截断的话 ×1 那组的数字会更难看。
11.3 运行完整脚本
完整脚本在 code/h_symlog.py,额外打印每组的 MSE 与"最差组/最佳组"比值,并输出上面这张两面板的图。
12. 延伸阅读
- 02-生成式世界模型 — 生成式世界模型在无人机中的应用
- 03-模型强化学习世界模型 — Dreamer 系列详解及无人机竞速应用
- 04-3D场景世界模型 — NeRF 和 3DGS 作为世界模型
- 05-无人机世界模型综述 — 无人机专用世界模型的全景综述
- 06-关键数据集与基准 — 评估世界模型的基准与数据集
13. 思考题
题目 1:潜在状态 vs. 视频预测
Dreamer 系列使用潜在状态模型(latent state model),而 UniSim 使用视频预测模型。分析这两种范式在无人机应用中的优劣。
参考答案
**潜在状态模型(Dreamer 风格)的优势:** - 计算高效:潜在空间维度远低于像素空间,规划速度更快 - 适合机载部署:模型体积小,可在嵌入式设备运行 - 端到端优化:状态表征直接为决策服务,不浪费容量在无关细节上 **潜在状态模型的劣势:** - 视觉信息损失:压缩可能丢失对安全关键的细节(如细小障碍物) - 难以与人类交互:无法直接可视化预测结果 **视频预测模型(UniSim 风格)的优势:** - 信息丰富:保留完整的视觉信息 - 可与预训练视觉模型结合:利用大规模视觉基础模型 - 可解释性:预测结果直观可理解 **视频预测模型的劣势:** - 计算成本高:视频生成需要大量算力,难以机载实时运行 - 物理一致性:可能生成视觉上合理但物理上不可行的场景 - 长期预测:误差累积在像素空间更严重 **无人机应用的权衡:** - 对于实时避障:潜在状态模型更合适(需要快速规划) - 对于任务预览/调试:视频预测模型更有用(可视化效果好) - 混合方案可能是最优解:用潜在状态做实时规划,用视频预测做离线验证题目 2:DreamerV3 的跨域能力
DreamerV3 使用固定超参数在多个领域取得 SOTA。分析 Symlog 变换和自由比特正则化如何实现这一成就。
参考答案
**Symlog 变换的作用:** - 不同任务的奖励和观测尺度差异巨大(Atari 奖励 0-100,DMControl 奖励 0-1000,Minecraft 更大) - Symlog: f(x) = sign(x) * log(1 + |x|) 将任意尺度压缩到对称范围 - 逆变换 Symexp 恢复原始尺度 - 效果:网络输出层不需要针对不同任务调整,统一了优化难度 **自由比特正则化的作用:** - 问题:KL 散度项在总损失中占比不当可能导致两个问题 - 过大:表征被压缩到先验,丢失信息(posterior collapse) - 过小:表征过于复杂,过拟合 - 自由比特:设定 KL 散度的最小值(如 1 nat/维度),低于此值时不施加 KL 惩罚 - 效果:确保每个潜在维度至少编码一定量信息,防止信息丢失 **两者的协同:** - Symlog 统一了损失函数的尺度 - 自由比特确保表征的信息量 - 两者共同使得单一超参数配置适应不同领域的不同信号尺度和信息密度题目 3:视频生成模型是否是世界模型?
围绕 Sora 等视频生成模型是否构成"世界模型"展开讨论,结合无人机应用场景给出你的观点。
参考答案
**正方观点(视频生成是世界模型):** - 世界模型的核心功能是"预测未来状态",视频生成模型正是如此 - 大规模视频预训练隐式学习了物理规律(重力、碰撞、运动学) - 可以作为训练数据生成器(sim-to-real 的新范式) - 不需要显式物理引擎即可产生物理上大致合理的预测 **反方观点(视频生成不是世界模型):** - 世界模型的关键是"可控性"和"一致性",视频生成模型缺乏保证 - 无法进行精确的状态估计和规划(如:精确的 6-DoF 位姿) - 物理一致性是"学到的"而非"保证的",可能在分布外失败 - 无人机安全关键应用需要可验证的模型 **对无人机的具体分析:** - 任务规划层:视频世界模型可以用于粗粒度的任务预演 - 运动规划层:需要精确的状态预测,视频模型不够 - 控制层:需要精确的动力学模型,视频模型完全不适用 - 结论:视频世界模型可以作为辅助工具,但不能替代结构化的动力学世界模型 **折中观点:** - "世界模型"是一个光谱,不是二元分类 - 视频生成模型是"弱世界模型",在某些维度(视觉真实性)上强,在其他维度(精确可控性)上弱 - 未来方向:将视频生成与结构化状态表征结合题目 4:RSSM 设计选择
分析 Dreamer RSSM 中确定性路径和随机性路径各自的作用。如果去掉其中一个会怎样?
参考答案
**确定性路径(GRU h_t)的作用:** - 捕捉时序依赖和序列模式 - 提供稳定的隐状态,作为随机路径的"锚点" - 类似于 RNN 的记忆功能 - 适合建模可预测的环境动态 **随机性路径(s_t)的作用:** - 建模环境的内在随机性(如对手行为、环境噪声) - 支持多模态预测(未来有多种可能) - 提供不确定性估计(可用于探索) - 防止确定性路径过拟合单一轨迹 **去掉确定性路径(纯随机模型):** - 失去时序记忆能力 - 多步预测退化为独立的单步预测 - 类似于非递归的 VAE,无法建模长程依赖 **去掉随机性路径(纯确定性模型):** - 无法建模多模态未来 - 预测结果趋向"平均"(blurry predictions) - 在随机环境中表现极差 - 类似于确定性 RNN,容易在分布外失败 **双路径的协同效应:** - 确定性路径处理"可预测的部分"(如惯性、重力) - 随机性路径处理"不可预测的部分"(如风扰动、其他智能体行为) - 两者融合提供准确且鲁棒的状态预测下一节:02-生成式世界模型 — 了解生成式世界模型如何为无人机创建逼真的飞行场景预测。